KI-Agenten sind startklar. Sind Ihre Produktdaten es auch?
KI-Agenten brauchen mehr als ein gutes Tool: Drei Dinge, die Ihre Produktdaten AI-ready machen
In Kundengesprächen hören wir gerade oft dieselbe Frage: „Brauche ich SEO überhaupt noch? Jetzt ist doch GEO das große Thema.“ Unsere Antwort: SEO bleibt wichtig, denn KI-Suchen stützen sich auf dieselben Webinhalte, die auch Suchmaschinen erfassen. Was sich verändert, sind die Anforderungen an diese Inhalte. Wer von KI-Agenten und KI-Suchen berücksichtigt werden will, braucht strukturierte, maschinenlesbare und vor allem konsistente Produktdaten. Sonst wird er in den Antworten schlicht übergangen.
Wie das in der Praxis aussieht, habe ich im Webinar „KI-Agenten & PXM“ gemeinsam mit Damian Deßler von ATAMYA gezeigt. Die wichtigsten Erkenntnisse fasse ich hier zusammen.
Was bedeutet AI-Readiness im Produktdatenmanagement?
AI-Readiness (auch KI-Readiness) bedeutet, dass ein Unternehmen die Daten, die technischen Verbindungen und die organisatorischen Regeln hat, die ein konkreter KI-Anwendungsfall braucht. Im Produktdatenmanagement heißt das vor allem: Ein KI-Agent kann auf verlässliche Produktinformationen zugreifen, und es ist klar geregelt, wofür er zuständig ist und wofür nicht.
Wir betrachten AI-Readiness deshalb entlang von drei Dimensionen:
Daten:
Sind Produktinformationen strukturiert, vollständig und über alle Kanäle konsistent?
Technologie:
Sind Systeme und Workflows so verbunden, dass KI, Automatisierung und fachliche Prüfung ineinandergreifen?
Organisation:
Sind Verantwortlichkeiten, erlaubte KI-Dienste und der Umgang mit Unternehmensdaten geklärt?
PIM, DAM und PXM kurz erklärt
Ein PIM (Product Information Management) ist der zentrale Ort für Produktinformationen. Ein DAM (Digital Asset Management) verwaltet die zugehörigen Bilder und Dokumente, etwa Zertifikate. PXM (Product Experience Management) nutzt beides, um für jede Zielgruppe und jeden Kanal die passenden Informationen bereitzustellen.
Kurz: PIM ist die Grundlage, PXM das Ziel.
AI-Readiness heißt: Ein Unternehmen hat die Daten, technischen Verbindungen und organisatorischen Regeln, die für einen konkreten KI-Anwendungsfall nötig sind. Entscheidend ist nun, kann der KI-Agenten auf verlässliche Informationen zugreifen, und ist klar, wofür er zuständig ist und wofür nicht?
Warum verstreute Produktdaten KI-Agenten ausbremsen
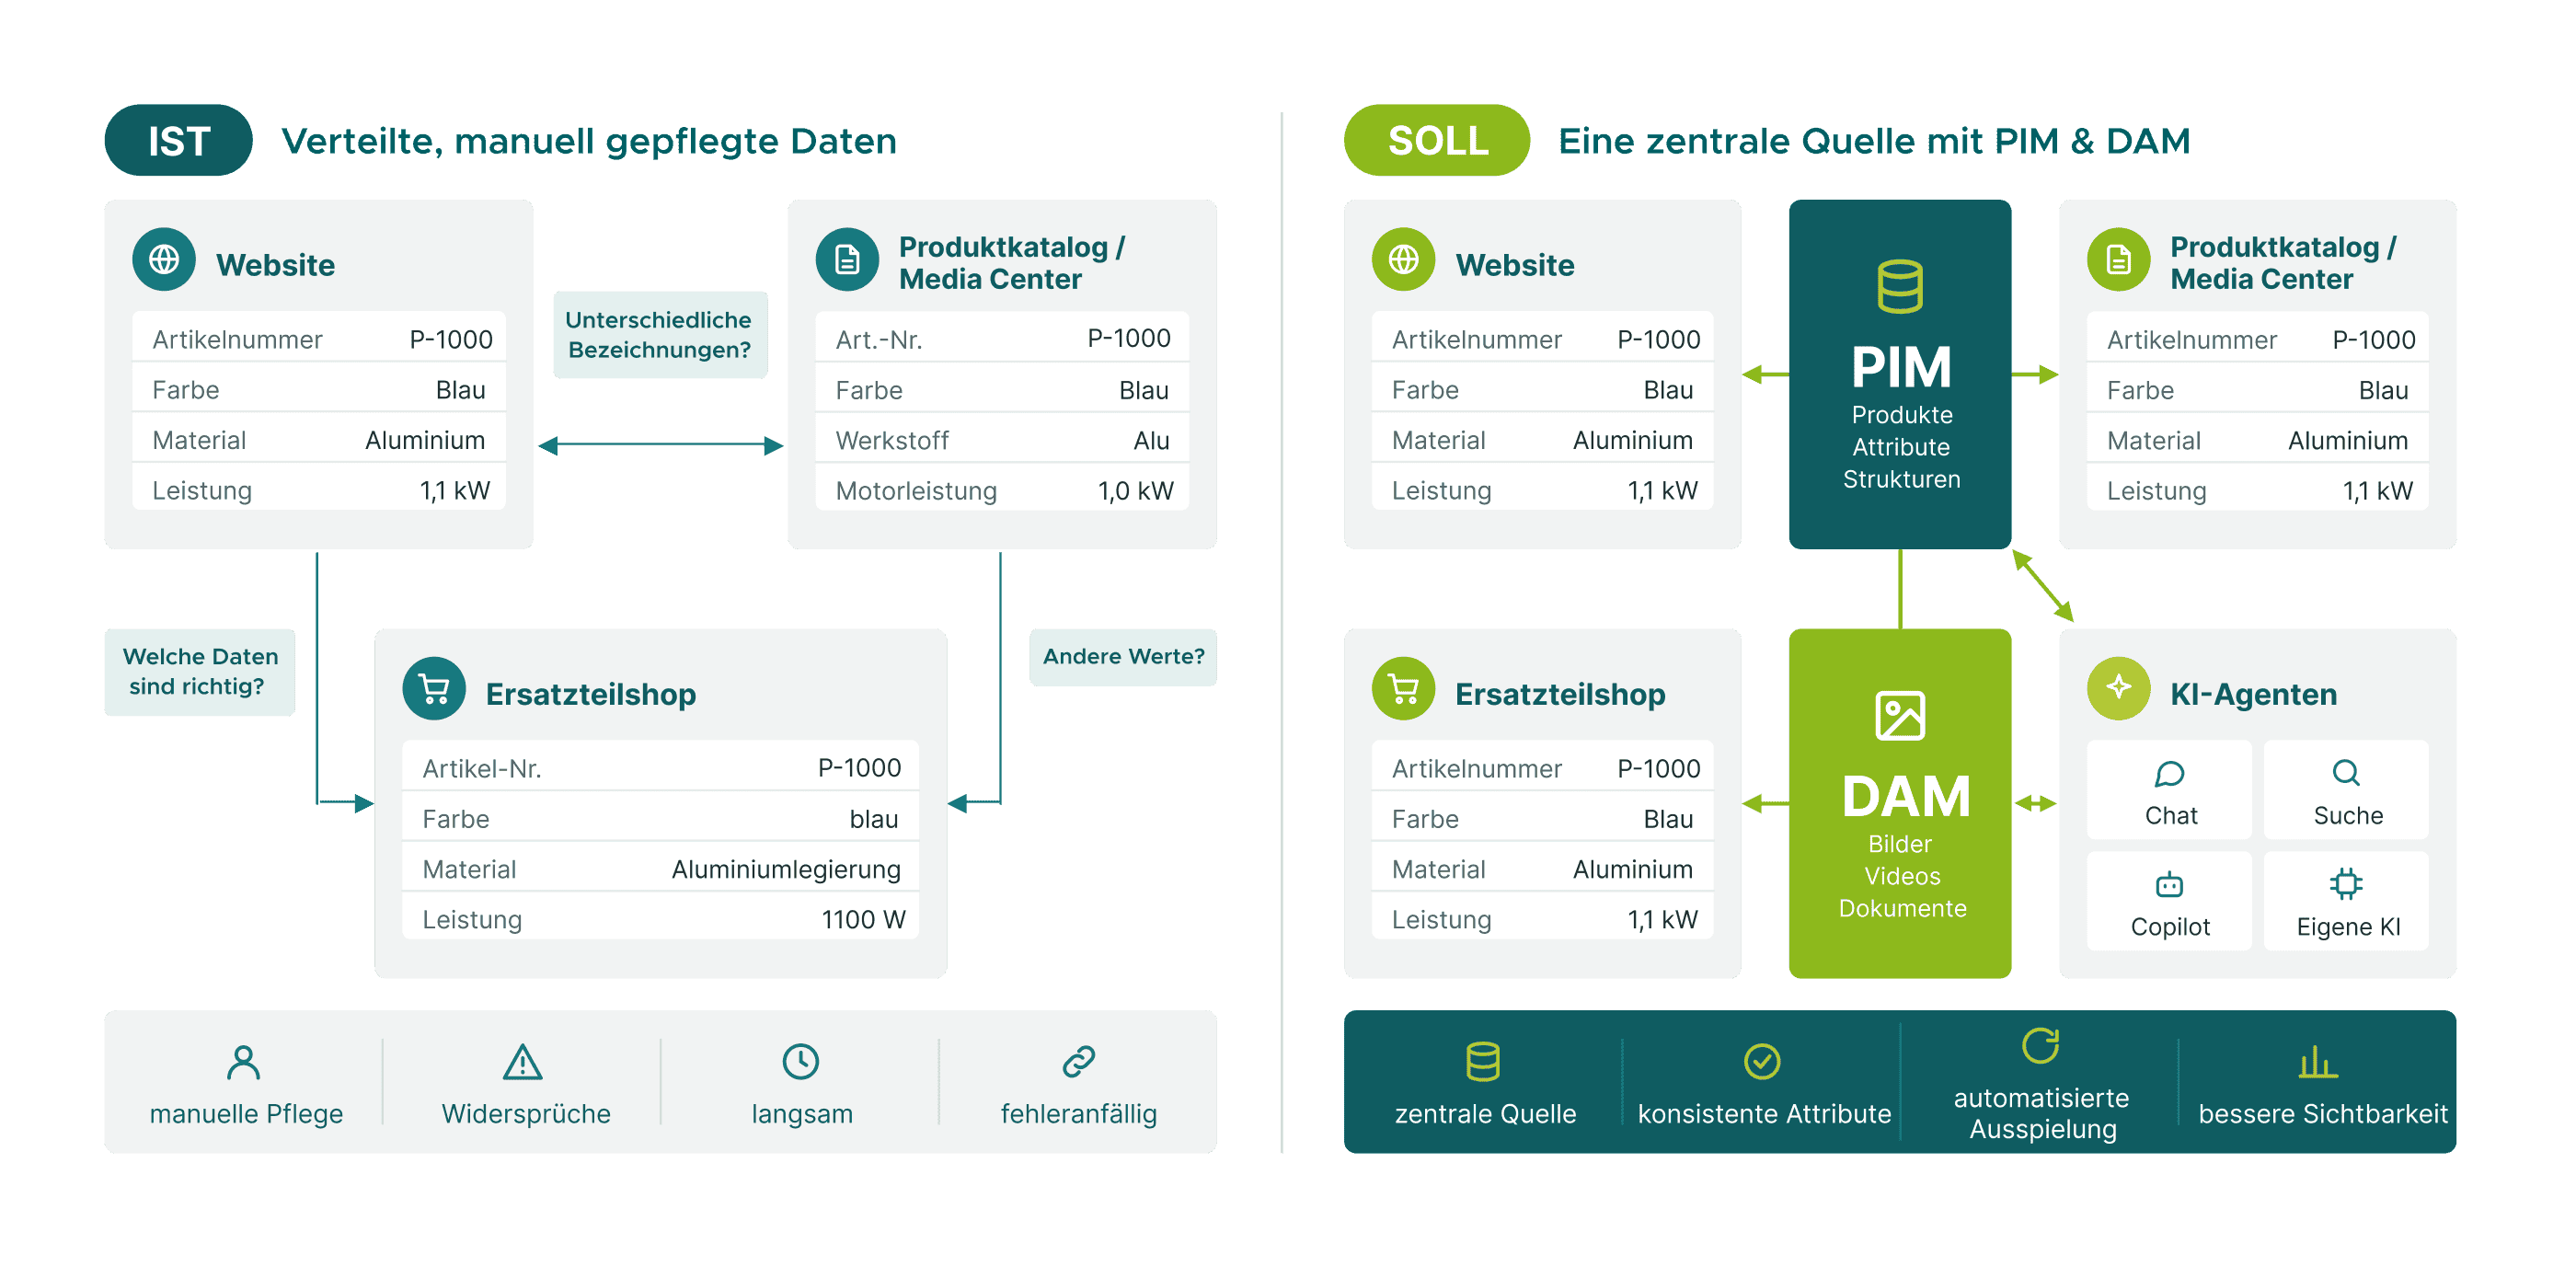
Die Ausgangslage kennen viele Unternehmen: Die Corporate Website zeigt Produkte, Bilder und Kategorieseiten, gepflegt von Online-Redakteuren, oft noch weitgehend manuell. Für Details verweist sie auf einen Produktkatalog oder ein Media Center, also ein anderes System mit anderer Struktur. Dazu kommt vielleicht ein Ersatzteilshop mit wieder eigenen Daten.
Das Ergebnis sind uneinheitliche Attribute. Jedes System ist für seinen Zweck gepflegt, aber keines ist auf die anderen abgestimmt. Wenn dann die KI-Suche Druck macht, klebt man überall ein Pflaster drauf und gleicht von Hand an. Das ist langsam, fehleranfällig und aufwendig, und die gewünschte Sichtbarkeit stellt sich trotzdem nicht ein.
1. Strukturierte Produktdaten machen KI-Agenten erst nutzbar
Ohne ein sauberes Datenmodell hat ein KI-Agent nichts, worauf er sich verlassen kann. Wie schnell sich ein solches Modell heute entwerfen lässt, haben wir im Webinar live gezeigt.
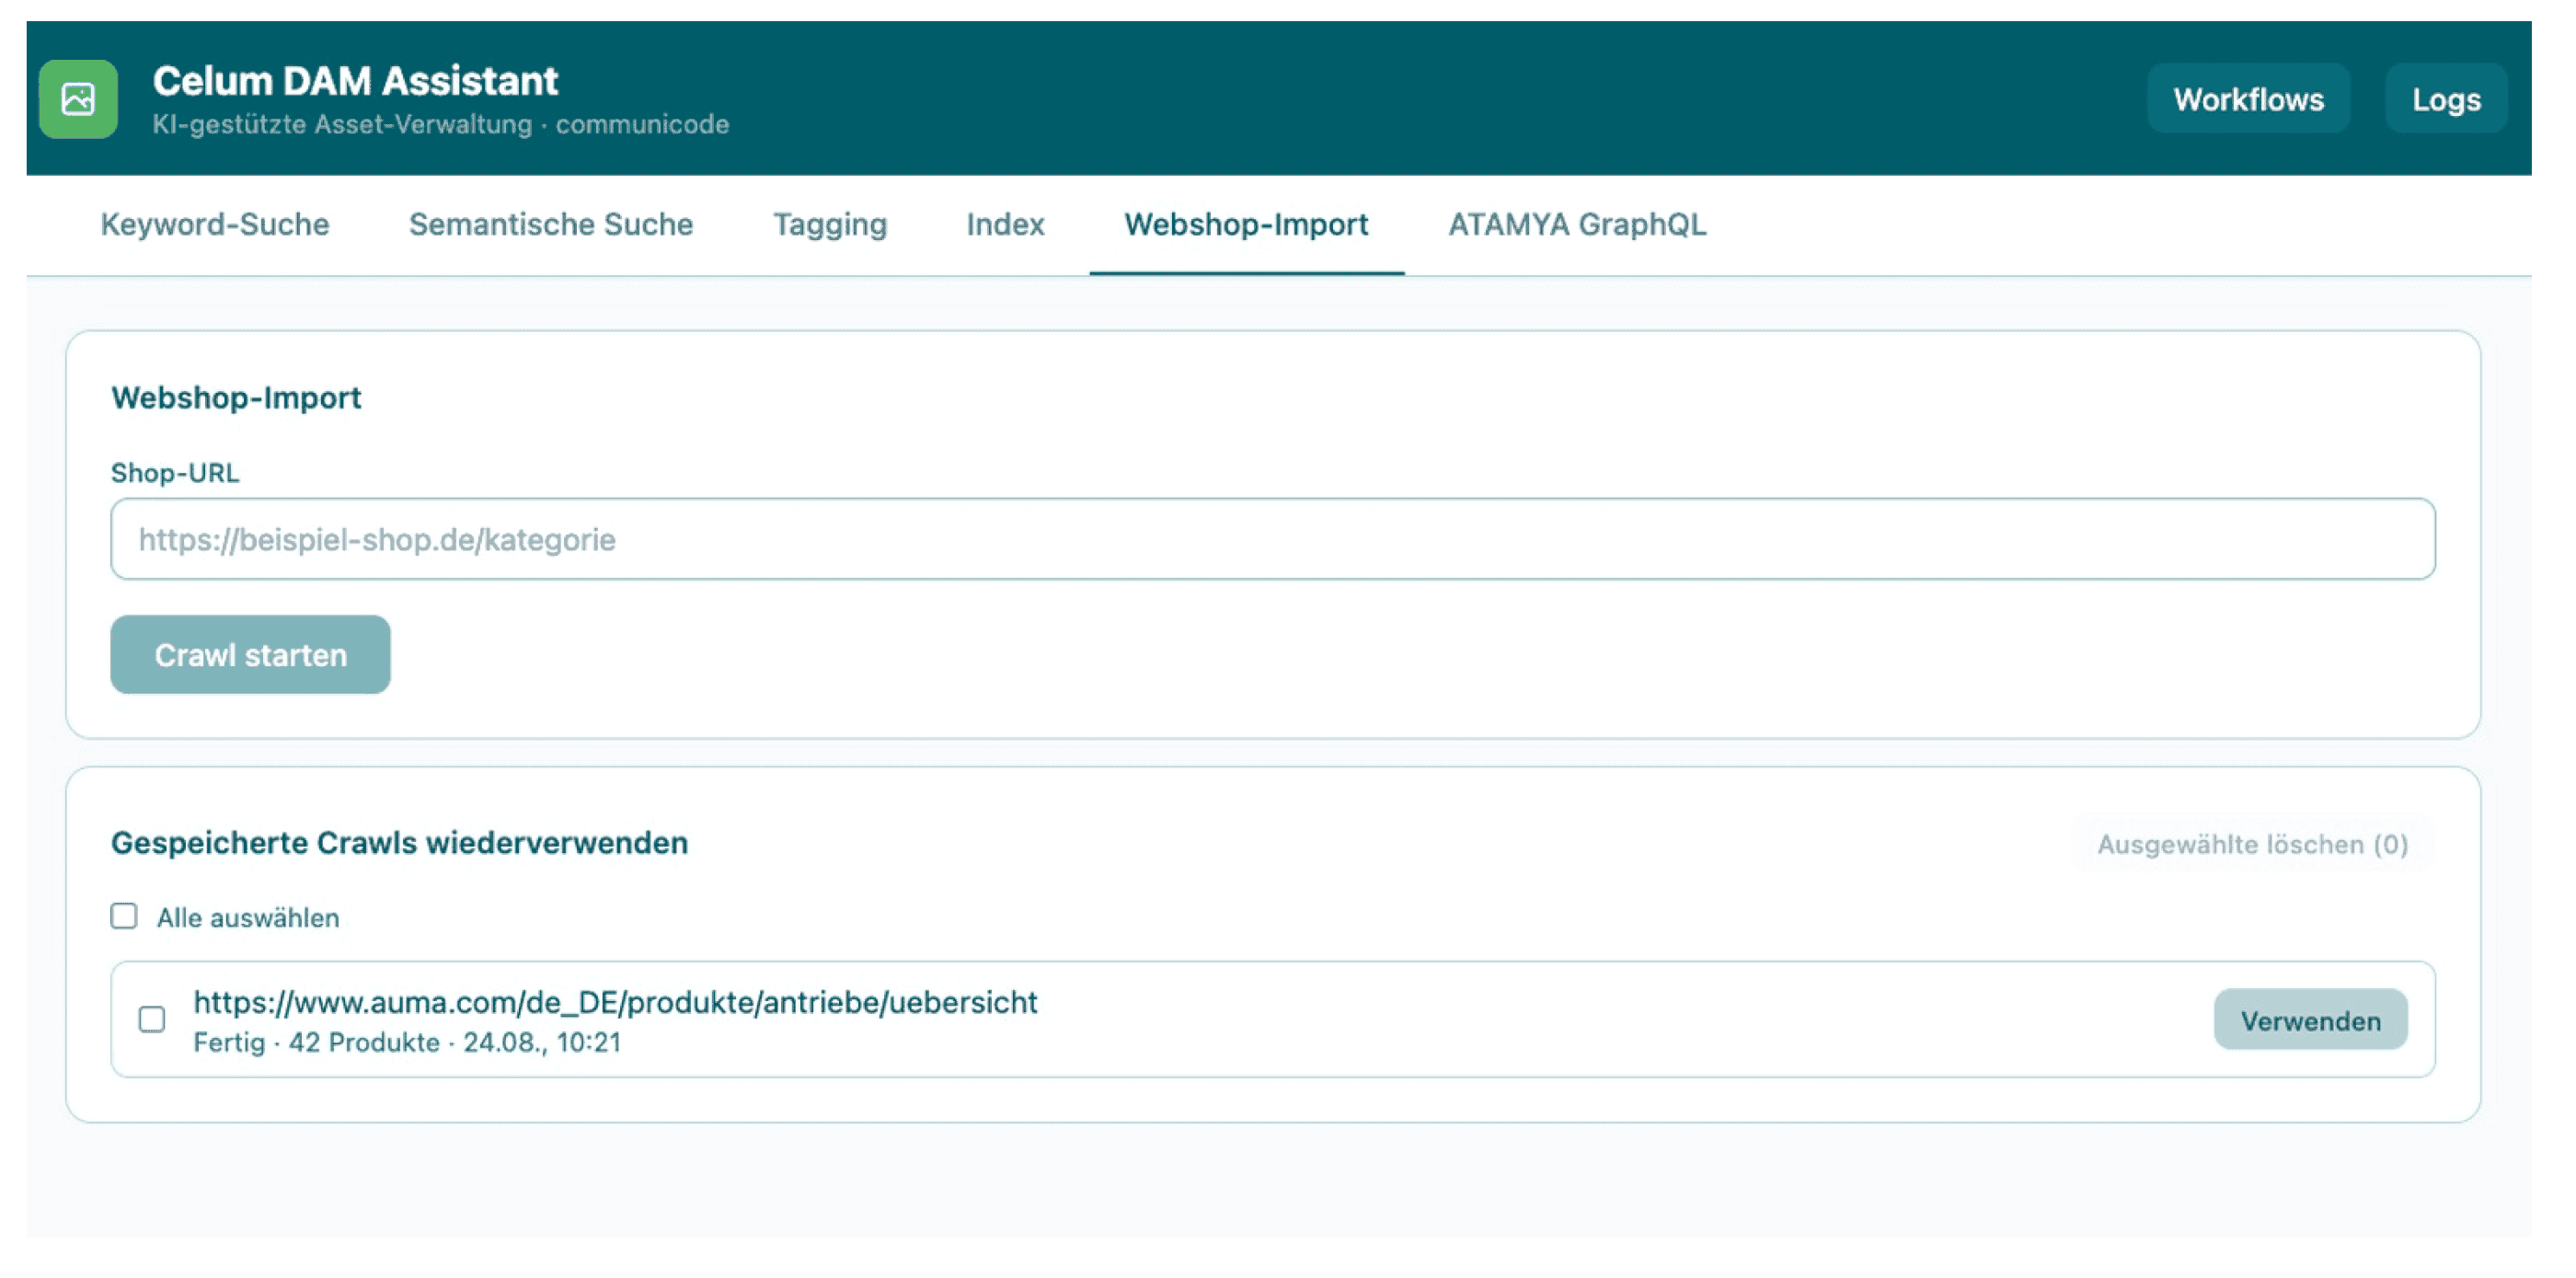
Für den Showcase haben wir Produktseiten einer Kundenwebsite crawlen lassen. Unser PXM-Assistent hat Kategorien, Attribute und Werte erfasst und in ein Datenmodell überführt, das sich ohne manuelle Eingabe in ATAMYA übertragen lässt. Im Beispiel waren das 42 Produkte, vier Objekttypen und 53 Attribute. Die Übertragung lief live durch.
Damian hat dazu etwas Bezeichnendes angemerkt: Ein Datenmodell gemeinsam mit einem Unternehmen zu erarbeiten, kann Monate dauern. Die KI ersetzt diese Arbeit nicht, liefert aber in kurzer Zeit einen Vorschlag, mit dem man arbeiten kann. Dasselbe Prinzip hilft, wenn Sie viele Lieferantenstammdaten in Ihr Zieldatenmodell bringen müssen.
Wo der Mensch gefragt bleibt
Der Assistent hat auch Attribute vorgeschlagen, die er zusammenführen würde. „Stellzeit“ und „Stellzeitbereich“ lassen sich gut konsolidieren. Bei „Gehäusematerial“ und „Schraubenmaterial“ ist das schon nicht mehr so klar. Ähnlich heißt nicht gleichbedeutend. Ob zwei Attribute zusammengehören, entscheidet das Produktwissen, nicht die sprachliche Ähnlichkeit.
2. Datenqualität braucht klare Workflows und gezielte Prüfungen
Mit dem Import beginnt die eigentliche Arbeit. Damian hat gezeigt, wie das in einem definierten Workflow aussehen kann.
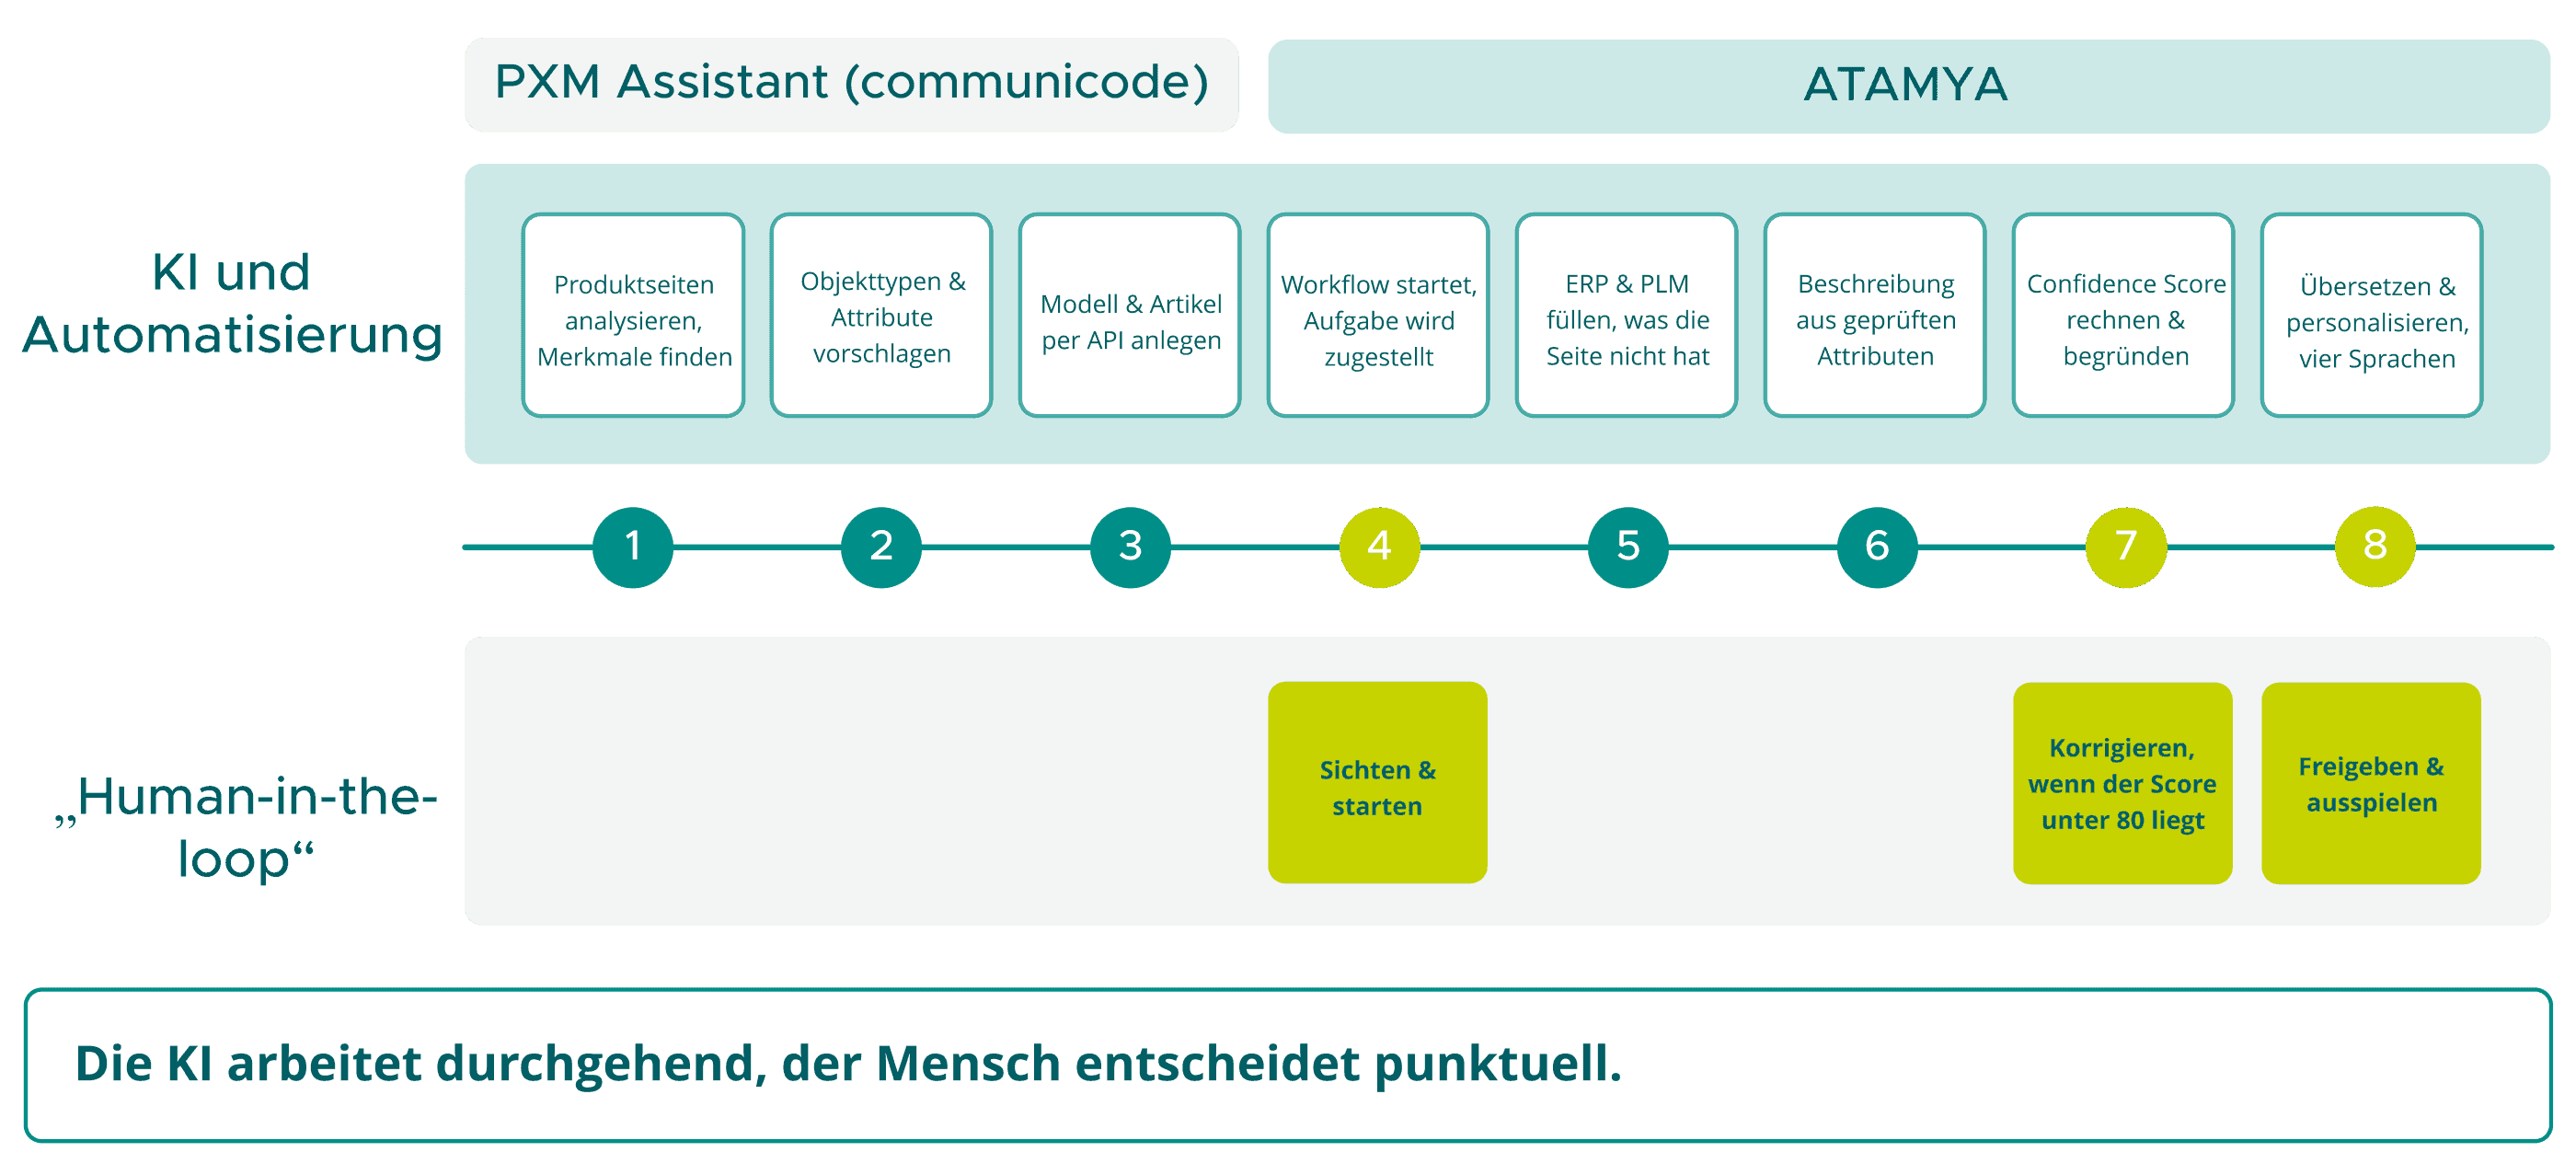
Sobald ein Produkt angelegt wird, entsteht automatisch eine Aufgabe für den Produktmanager. Er legt per Formular fest, in welche Sprachen übersetzt wird, für welche Zielgruppen die Texte aufbereitet werden und für welche Kanäle das Produkt vorbereitet wird. Danach läuft vieles im Hintergrund: Daten aus dem ERP kommen dazu, Attribute werden abgeleitet, und ein KI-Agent entwirft die Produktbeschreibung.
Quality Gates und Confidence Score: So wird Datenqualität geprüft
Besonders aufschlussreich ist der zweite Agent im Workflow. Er schreibt nichts, er prüft nur. Dieser Governance-Agent analysiert die Daten, bewertet sie mit einem Confidence Score und zeigt dem Produktmanager, wo er genauer hinschauen sollte. Bei Produkten mit Hunderten von Attributen ist das eine echte Hilfe.
Ein Quality Gate ist ein definierter Prüfpunkt im Workflow, an dem ein Mensch eingebunden wird. Im Beispiel lag der Schwellenwert bei 80 Prozent. Das Produkt kam auf 45 Prozent, deshalb landete die Aufgabe bei einem Menschen. Wichtig: Der Score ist eine Entscheidungshilfe in diesem Workflow, kein Beweis für fachliche Richtigkeit.
Der Produktmanager fand tatsächlich einen Wert, der nicht stimmen konnte, und korrigierte ihn. Die Datenqualität im PIM stieg dadurch von 42 auf 74 Prozent und nach den letzten Ergänzungen auf 100 Prozent. Zu diesen Ergänzungen gehören Informationen, die nicht von der KI kommen:
Einheiten:
Kommt ein Gewicht aus einem Fremdsystem in Gramm, rechnet das PIM es regelbasiert in die Basiseinheit um.
Normen und Standards:
Sie ergänzt der Fachmann.
Zertifikate:
Sie werden direkt aus dem angebundenen DAM zugeordnet, was gerade für Kunden im technischen Umfeld wichtig ist.
Ein zweites Quality Gate galt den Produktbeschreibungen. Die KI hatte sie neutral erzeugt und zusätzlich für verschiedene Zielgruppen formuliert, etwa für Engineering und den technischen Einkauf. Beide Varianten basieren auf denselben freigegebenen Merkmalen, setzen aber unterschiedliche Schwerpunkte. Übersetzt wurde ins Englische und Chinesische, in der Demo mit DeepL. Auch eine strukturierte Darstellung für generative Suchen lässt sich über Schnittstellen bereitstellen.
Was KI übernehmen sollte und was nicht
Nur weil man etwas mit KI machen kann, sollte man es nicht automatisch tun. Der Beispiel-Workflow bestand aus acht Schritten und drei Entscheidungen. Vieles davon ist klassische Automatisierung mit festen Regeln, wie sie sich auch mit Tools wie n8n oder Make bauen lässt. KI kommt dort ins Spiel, wo Texte entstehen oder Daten bewertet werden. Der Mensch im Prozess (Human-in-the-Loop) konzentriert sich auf das, was er am besten kann: bewerten, entscheiden, freigeben.
Nachvollziehbarkeit gehört dazu
Zur Kontrolle gehört eine lückenlose Historie. Ihr Team muss jederzeit sehen können, welcher Wert von einem Menschen geändert und welcher vom Workflow oder der KI erzeugt wurde, auch auf Ebene einzelner Attribute. Gerade beim KI-Einsatz ist das keine Kür.
3. AI-Readiness braucht klare Verantwortlichkeiten
Von den drei Dimensionen ist die Organisation die größte Hürde. Daten und Technologie bekommt man in den Griff. Wenn aber die Prozesse nicht funktionieren, die Menschen nicht mitziehen und keine Leitplanken definiert sind, hilft das beste Tool nichts.
Vor dem Start sollten unter anderem diese Fragen geklärt sein:
- Nutzen Mitarbeitende einen Unternehmensaccount für KI-Tools oder jeder seinen eigenen?
- Welche Plattformen sind erlaubt?
- Ist der Einsatz DSGVO-konform?
Wer das nicht klärt, kann sich das Thema sparen.
Braucht man in Zukunft noch ein PIM?
Gelegentlich hören wir: In fünf Jahren gibt es keine PIM-Systeme mehr, dann holt sich ein Agent die Daten aus allen Systemen, konsolidiert sie und spielt sie wieder aus. Technisch ist das mit entsprechendem Aufwand denkbar. Ich sehe es anders. Der Fokus des PIM verschiebt sich, es geht nicht mehr nur um Strukturen und Klassifikationen. Ein Agent interessiert sich aber erst für Ihre Daten, wenn die Struktur dahinter stimmt. Das PIM bleibt die Basis, auf der Konsistenz über alle Kanäle entsteht.
Wo liegt der Wettbewerbsvorteil?
Das KI-Tool können Ihre Wettbewerber ebenfalls einkaufen. Der Unterschied entsteht davor und danach: bei Daten, Prozessen und Zuständigkeiten. Wer seine Produktdaten konsistent, strukturiert und nachvollziehbar pflegt, hat bessere Voraussetzungen, von KI-Suchen und Agenten berücksichtigt zu werden. Neue Anwendungsfälle lassen sich dann auf einer vorhandenen Basis umsetzen, statt bei jedem Projekt erneut mit der Datenbereinigung zu beginnen.
Fazit: Klein anfangen, Zuständigkeiten klären
Sie müssen nicht Ihren gesamten Produktbestand auf einmal umbauen. Nehmen Sie eine überschaubare Produktgruppe und gehen Sie den Weg von der Quelle bis zur Veröffentlichung einmal komplett durch. Diese fünf Fragen helfen beim Einstieg:
- Gibt es eine verbindliche Quelle für Ihre Produktinformationen, und sind Abweichungen zwischen Kanälen sichtbar?
- Sind Attribute, Einheiten und die Zuordnung von Dokumenten eindeutig geregelt?
- Wissen Sie, welche Schritte Sie regelbasiert automatisieren, wo KI unterstützt und wo ein Mensch prüft?
- Können Sie nachvollziehen, wer oder was einen Wert geändert hat?
- Sind Verantwortlichkeiten, erlaubte KI-Dienste und der Umgang mit Unternehmensdaten geklärt?
Offene Antworten sind kein Problem, sie zeigen, wo Sie ansetzen können. Wenn Sie Ihre Ausgangslage genauer einordnen möchten, ist unser Agentic Readiness Check ein guter erster Schritt. Anschließend prüfen wir gemeinsam, welcher Prozess sich für Ihren Einstieg eignet.
FAQ – Häufige Fragen zur AI-Readiness von Produktdaten
Mischa Wolfframm
Mischa Wolfframm ist Director Consulting bei communicode und unterstützt Unternehmen dabei, ihre Commerce‑ und Prozesslandschaften digital und effizient auszurichten. Sein Fokus liegt auf skalierbaren Lösungen, die Vertriebs‑, Logistik- und Fulfillment‑Prozesse spürbar verbessern. Zuvor sammelte Mischa internationale Erfahrung, unter anderem bei Triumph in Japan. Wenn er nicht an digitalen Prozessketten arbeitet, spricht er über B2B‑Commerce‑Strategien, Automatisierung und pragmatische Lösungen, die im Alltag wirklich funktionieren.